


Aktuelles
Conventionally Developed Versus Large Language Model-Generated Exam Tasks in Higher Education: A Comparative Analysis
[30.10.2026]Neue Publikation des Lehrstuhls
New publication of the chair
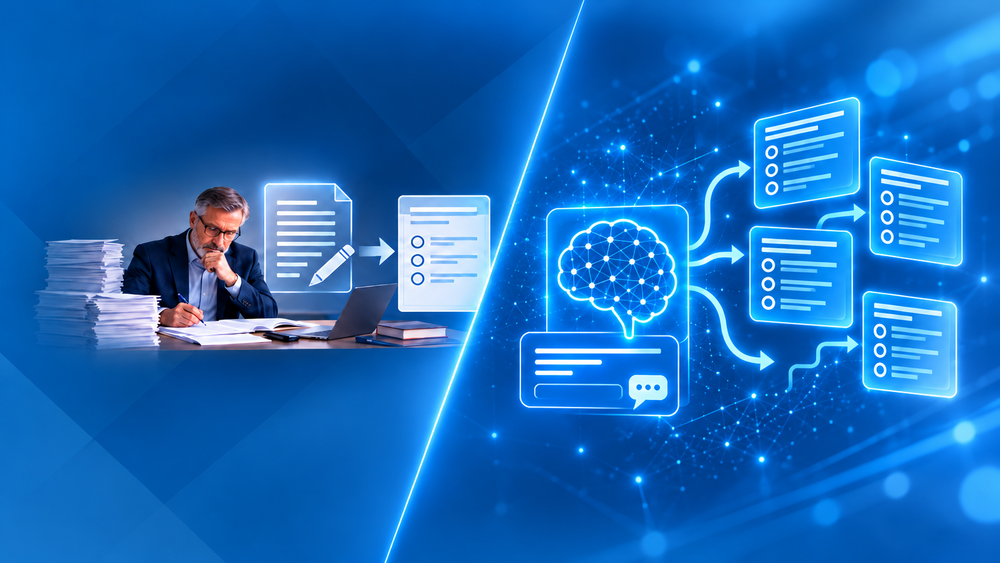 Foto: OpenAI
In der Zeitschrift Journal of Digital Educational Technology wurde folgender Beitrag veröffentlicht:
Niklas Lettow/Kristopher Pantani/Prof.Dr.Jörn Littkemann: Conventionally Developed Versus Large Language Model-Generated Exam Tasks in Higher Education: A Comparative Analysis, in: Journal of Digital Educational Technology, Volume 6, Issue 2, October 2026, https://doi.org/10.29333/jdet/19699
Abstract:
Diese explorative Feldstudie untersucht, wie sich LLM-generierte Prüfungsaufgaben im Vergleich zu konventionell erstellten Prüfungsaufgaben hinsichtlich ausgewählter Qualitätskriterien bewähren. Die methodische Auswertung basiert auf einer Kombination aus deskriptiven Statistiken, t-Tests für abhängige Stichproben und Wilcoxon-Vorzeichen-Rang-Tests. Die Ergebnisse verdeutlichen, dass die untersuchten Qualitätskriterien bei den LLM-generierten im Vergleich zu den konventionell erstellten Aufgaben weitgehend ähnliche Werte aufwiesen, sich in einigen Fällen jedoch auch statistisch signifikante Unterschiede zeigten.
Weitere Publikationen des Lehrstuhls finden Sie auf der Publikationsseite des Lehrstuhls.
The following article was published in the magazine Journal of Digital Educational Technology
Niklas Lettow/Kristopher Pantani/Prof.Dr.Jörn Littkemann: Conventionally Developed Versus Large Language Model-Generated Exam Tasks in Higher Education: A Comparative Analysis, in: Journal of Digital Educational Technology, Volume 6, Issue 2, October 2026, https://doi.org/10.29333/jdet/19699
Summary:
This exploratory field study investigates the performance of LLM-generated exam tasks compared with conventionally developed exam tasks in terms of selected quality criteria. The statistical analysis combines descriptive statistics with paired-sample t-tests and Wilcoxon signed-rank tests. The results indicate that LLM-generated and conventionally developed exam tasks exhibited largely similar values across the examined quality criteria, although statistically significant differences were observed in some comparisons.
Further publications of the chair can be found on the chair's publications page.


