


Aktuelles
Wie lernen Studierende wirklich? Dr. Kamila Misiejuk will es sichtbar machen
[11.11.2026]Dr. Kamila Misiejuk erhielt den Forschungspreis 2026 der FernUniversität in der Kategorie Nachwuchs. Sie forscht als Postdoc in der Forschungsprofessur „Learning Analytics“ von Jun.-Prof. Dr. Ioana Jivet. Im Gespräch erklärt sie, wie sich Lernprozesse mit KI untersuchen lassen und warum es auf die Reihenfolge ankommt.
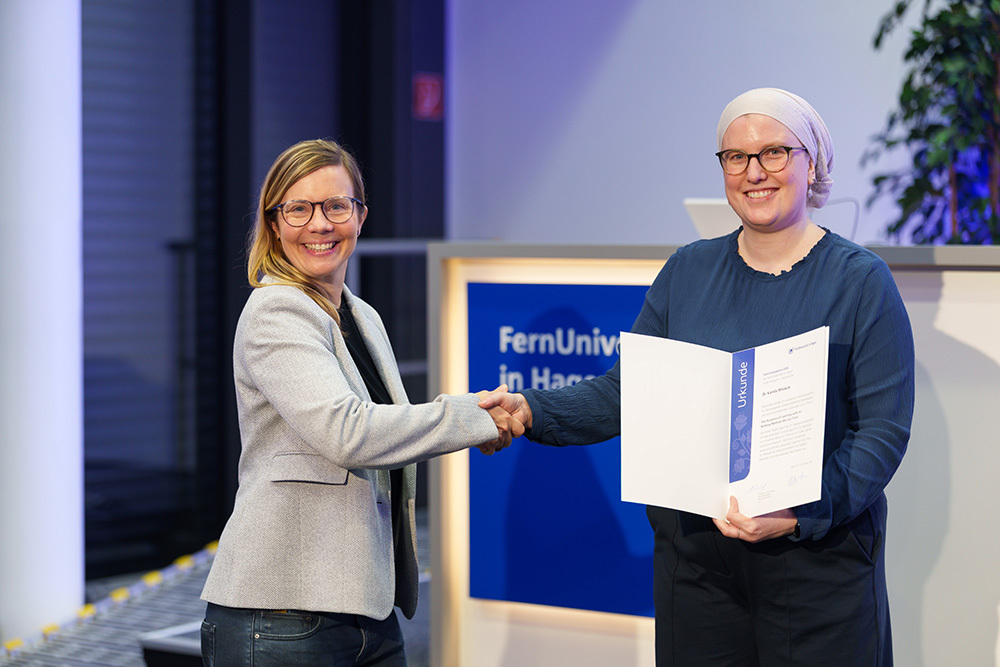 Foto: Volker Wiciok
Kamila, du hast den Forschungspreis Nachwuchs unter anderem dafür bekommen, dass du neue Ansätze in der Analyse von Lernprozessen verfolgst. Kannst du uns ein wenig mehr dazu erklären, was genau du machst?
Ich entwickle Methoden, mit denen sich untersuchen lässt, wie Lernen über die Zeit verläuft, und Verfahren, die sicherstellen, dass diese Methoden vertrauenswürdig sind. Ein Gespräch, eine Arbeitsgruppe oder der Austausch einer Studentin mit einem KI-Tool ist eine Abfolge von Handlungen. Ich mache sichtbar, welche Handlungen zusammen auftreten und welche aufeinander folgen.
Wie sieht das konkret aus?
Am Anfang steht das Codieren: Forschende gehen die Daten Schritt für Schritt durch und ordnen jeder Äußerung passende Kategorien zu. Schreibt eine Studentin etwa an die KI: „Ich verstehe den zweiten Schritt nicht, kannst du ihn mir erklären?“, dann erhält diese Äußerung zwei Kategorien: „erkennt eine Verständnislücke“ und „bittet um Hilfe“.
Anschließend wird gezählt, wie oft auf eine Kategorie eine bestimmte andere folgt, zum Beispiel wie oft auf „bittet um Hilfe“ als Nächstes „überprüft die Antwort“ folgt. Das Ergebnis wird als Netzwerk dargestellt. Darin ist auf einen Blick zu sehen, welche Schritte in der Interaktion zwischen Studierenden und KI häufig aufeinander folgen. So entsteht ein Modell des Lernprozesses.
Dabei kommt es mir auf zweierlei an. Die Modelle müssen statistisch stabil sein, das lässt sich mit entsprechenden Tests prüfen. Und sie müssen den Daten treu bleiben, also ein verlässliches Bild davon liefern, was in der Interaktion mit der KI tatsächlich passiert. Deshalb schaut man immer wieder in die ursprünglichen Gespräche und prüft, ob das Modell dem gerecht wird.
 Foto: Volker Wiciok
Wo liegt hier dein eigener Beitrag?
Bei der Codierung. Gängige Maße für die Übereinstimmung zwischen Codierenden zeigen nur, ob zwei Personen dieselben Codes vergeben. Sie sagen nichts darüber, ob sie auch dieselbe Reihenfolge sehen. Für Prozessmethoden ist die Reihenfolge aber entscheidend. Ich habe ein dreistufiges Verfahren mit zwei neuen Maßen entwickelt. Sie zeigen Code für Code, ob die Codierenden auch bei der Abfolge übereinstimmen.
Das Codieren übernehmen heute oft Sprachmodelle. Ist das ein Problem?
Es kann eines sein. Meine systematische Übersichtsarbeit hat gezeigt: Viele Studien prüfen die Zuverlässigkeit der KI-Codierung, andere nur unsystematisch oder unzureichend. Das ist besonders heikel, wenn auf Grundlage dieser Codierung Dashboards erstellt oder Rückmeldungen an Studierende und Lehrende gegeben werden: Ist die Codierung unzuverlässig, sind es auch die Dashboards und Rückmeldungen. Außerdem stimmen Sprachmodelle mit menschlichen Codierenden bei den feinen, kontextabhängigen Kategorien nur mäßig überein, und gerade die sind oft die wichtigsten. In einer aktuellen Studie zeige ich, dass sich solche Codierfehler über automatisierte Rückmeldungen fortpflanzen und Schlussfolgerungen über das Lernen verzerren können.
 Foto: Hardy Welsch
Wenn eine KI die Arbeit erledigen kann, müssen wir fragen, ob ein Abschluss noch echtes Lernen belegt. Dafür brauchen wir verlässliche Evidenz darüber, wie Studierende tatsächlich mit KI umgehen.
Dr. Kamila Misiejuk
Zu welchen Erkenntnissen konntest du mit diesen Methoden bisher beitragen?
In einer Längsschnittstudie zeigte sich: Wenn Studierende eine KI anweisen, lagern sie häufig mühevolles Denken aus, statt ihr Verständnis zu vertiefen. Die Qualität der Arbeiten hängt davon ab, wie gefragt wird. Starke Abgaben zeichnen sich durch zusammenhängende, gut eingebettete Prompts aus, schwächere durch bloße Anweisungen und Widerspruch. In einer weiteren Studie veränderte die KI-Nutzung beim Schreiben von Essays nicht die Noten, aber die gegenseitige Bewertung. Das Feedback wurde unspezifischer und milder. Und in einem Programmierkurs war die Interaktion mit ChatGPT von oberflächlicher Selbstregulation geprägt, mit wenig tiefer Reflexion oder Selbstbewertung.
Was bedeutet das aus deiner Sicht für das Lernen an Hochschulen?
Generative KI ist in kürzester Zeit in der Bildung angekommen, oft bevor Lehrende ihre Wirkung einschätzen können. Wenn Studierende ihr Denken auslagern, kann KI genau die Fähigkeiten untergraben, die sie fördern soll. Wenn sie Unterschiede zwischen Lernenden verstärkt, droht mehr Ungleichheit. Und wenn eine KI die Arbeit erledigen kann, müssen wir fragen, ob ein Abschluss noch echtes Lernen belegt. Dafür brauchen wir verlässliche Evidenz darüber, wie Studierende tatsächlich mit KI umgehen.
Warum sind die FernUni und CATALPA ein guter Ort, um das zu beforschen?
An der FernUni lernen rund 75.000 Studierende überwiegend digital, was ein großes Potenzial speziell für Learning Analytics bietet. Zudem regelt eine Learning Analytics Ordnung die Datenerhebung, was für die Forschung Handlungssicherheit bietet. Im Forschungszentrum CATALPA mit seinem interdisziplinären Reallabor-Ansatz bekomme ich darüber hinaus immer wieder die richtigen und wichtigen Impulse aus anderen Perspektiven heraus und die Möglichkeit in realen Settings valide Ergebnisse zu produzieren. Für mich persönlich wichtig ist hier auch die Freiheit, experimentelle, methodische Projekte zu verfolgen und eigene Forschung zu leiten.
Stehen deine Methoden auch anderen zur Verfügung?
Das ist mir wichtig. Ich arbeite an frei verfügbaren Tutorials mit, helfe beim Entwickeln und Testen offener Software, wie CarmNote, und unterrichte die Methoden in Workshops und Sommerschulen. Zwei R-Pakete, Nestimate und cooccure, sind auf CRAN verfügbar.
Was sind nun deine weiteren Pläne für die Forschung und wofür wirst du das Preisgeld nutzen?
Bisher habe ich die neuen Maße an simulierten Daten getestet. Jetzt kommen reale Codierprojekte. Dabei zeigt sich, wie die Verfahren in der Praxis funktionieren, und wir können sinnvolle Schwellenwerte festlegen. Ein Diagnose-Tool, das Forschende durch das Vorgehen führt, die Maße berechnet und Uneinigkeiten sichtbar macht, gibt es schon. Ich würde mich freuen, wenn andere Forschungsgruppen es ausprobieren und ihre Erfahrungen teilen. Langfristig möchte ich daraus prozessbasierte Lernindikatoren, Modellierungstechniken und praktische Anwendungen entwickeln, die sich empirisch testen lassen. Dafür möchte ich größere Drittmittel beantragen.
Ich möchte meine Arbeiten Open Access veröffentlichen, auf Konferenzen vorstellen und möglicherweise eine Hilfskraft einstellen, die beim Codieren unterstützt. So können wir die Maße an authentischen Studierendendaten testen.
- Mehr zum diesjährigen Forschungspreis der FernUni | mehr
- Zum persönlichen Profil von Kamila Misiejuk | mehr
- Zur Forschungsprofessur Learning Analytics | mehr


